近期我們在 Kubernetes 上對一套 CloudNativePG(PostgreSQL 18.1,1 主 2 副本)叢集做效能摸底。將實例 CPU 配額從 8 核升至 16 核後,滾動重排程帶來了一組反直覺的結果:主庫效能明顯回落,而只讀副本吞吐暴漲了 35%。
檢視容器監控,滿載狀態下 PostgreSQL 實際只消耗了 8.2 核。CPU 尚未跑滿,從 8 核擴容到 16 核不可能憑空產生 35% 的吞吐增量。對照 Pod 重排程前後的宿主機落點後,原因很快浮出水面:重排程把主庫漂移到了一臺降頻節點上,同時把原本落在慢節點上的只讀副本遷移到了健康節點——所謂“加核快 35%”,其實是副本逃離慢節點的假象。我們順著 cpufreq 一路追到 MSR 倍頻暫存器,最終定位出兩臺空閒跌回 1.2 GHz、滿載下仍反覆掉檔的物理節點。
先校準測量方法:消除早期壓測噪聲
整次調優一共執行了 8 輪 pgbench 壓測,下文表格和圖表將其分為兩個階段:前 3 輪探索性測試記作 R1–R3,統一壓測口徑後的 5 輪正式對照實驗記作 E1–E5。
前 3 輪探索測試(R1–R3)存在明顯的測試方法缺陷:每次調整引數後都重新執行 pgbench -i 建表,且僅做單次取樣。在早期驗證穩定性的單併發副本摸底中,同一套配置連跑三輪竟得到 1,577 → 1,676 → 3,531 TPS,波動達到 2.2 倍(該摸底僅用於驗證噪聲,未計入後文高併發彙總表)。在這種噪聲下,任何引數改動都無法得到可靠結論。
從正式對照階段的首輪(E1)開始,我們固定了三條基準規範:
pgbench scale=200只初始化一次並常駐,所有對比輪次壓同一份資料集;- 每次重啟實例後先預熱一輪,把熱頁載入進
shared_buffers,每個場景跑 2 次取中位數; pgbench(純索引點查與更新)只用來觀測 CPU、fsync和協議開銷;順序掃描單獨測試儲存與非同步 I/O。
固化口徑後,同配置多次取樣的離散度收斂至 1%–3%,後續輪次的資料才具備可比性。
同款 CPU 與微碼下,單核基準慢 2.34 倍的排查過程
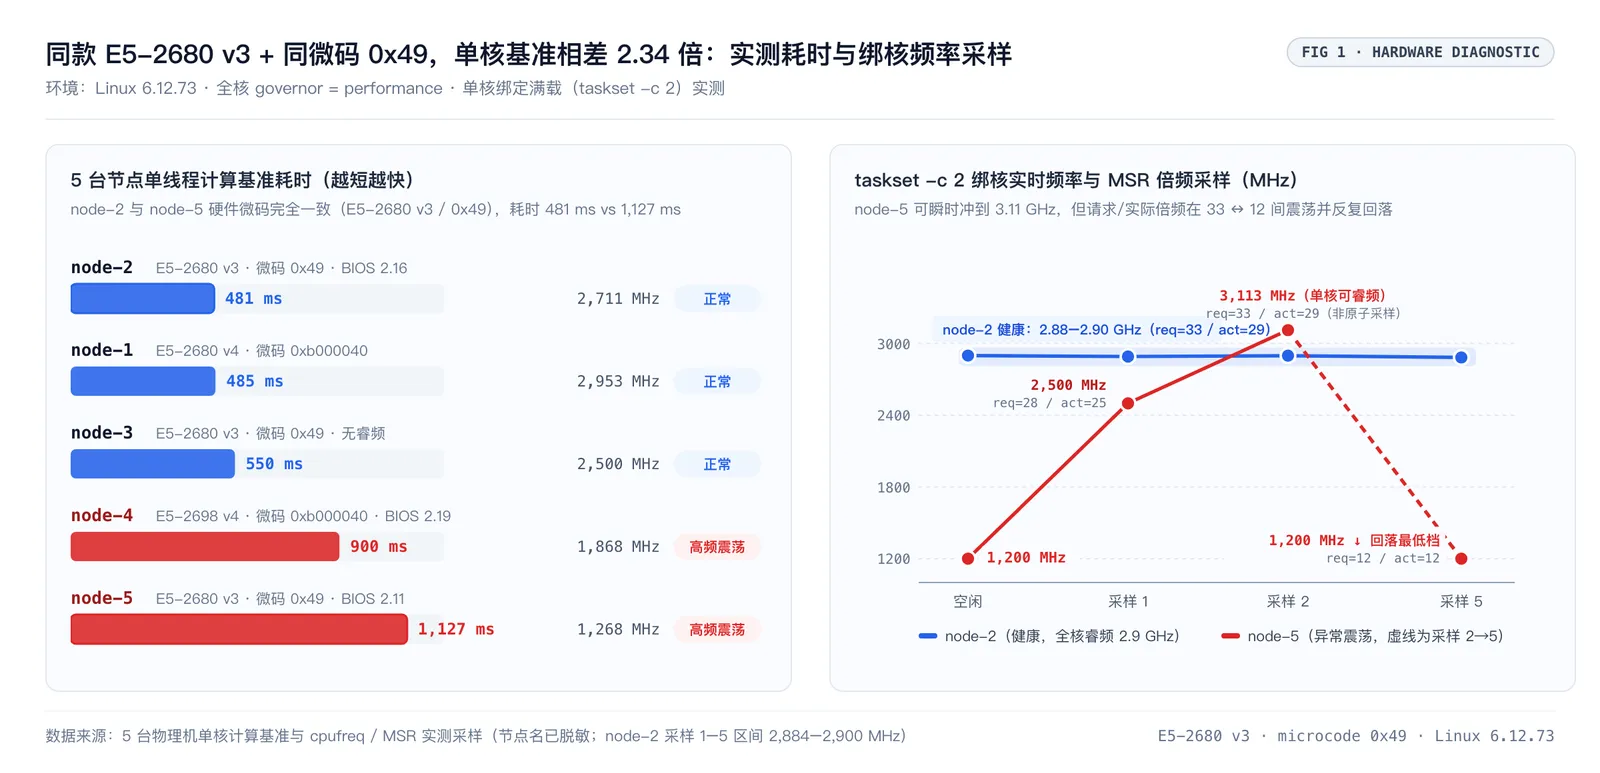
為了排除資料庫和 Kubernetes 的干擾,我們對集群裡的 5 臺物理機直接跑單執行緒純 CPU 計算基準,並記錄基準執行期間的實際頻率(下表按單執行緒耗時從快到慢排序,表中的“負載後頻率”為基準執行時的觀測值,與後文 taskset -c 2 綁核每秒抓到的瞬時頻率存在少量口徑差異):
| 節點(脫敏) | CPU 型號 | 微碼 | BIOS 版本 | 單執行緒計算基準 | 負載後頻率 | 狀態 |
|---|---|---|---|---|---|---|
node-2 | E5-2680 v3 | 0x49 | 2.16.0 (2022) | 481 ms | 2,711 MHz | 正常 |
node-1 | E5-2680 v4 | 0xb000040 | — | 485 ms | 2,953 MHz | 正常 |
node-3 | E5-2680 v3 | 0x49 | — | 550 ms | 2,500 MHz | 正常(無睿頻,跑滿基頻) |
node-4 | E5-2698 v4 | 0xb000040 | 2.19.0 (2023) | 900 ms | 1,868 MHz | 高頻震盪 |
node-5 | E5-2680 v3 | 0x49 | 2.11.0 (2019) | 1,127 ms | 1,268 MHz | 高頻震盪 |
node-2 和 node-5 使用同款 E5-2680 v3 處理器、相同微碼 0x49、相同 Linux 6.12.73 核心,單核計算耗時分別為 481 ms 和 1,127 ms,相差 2.34 倍。
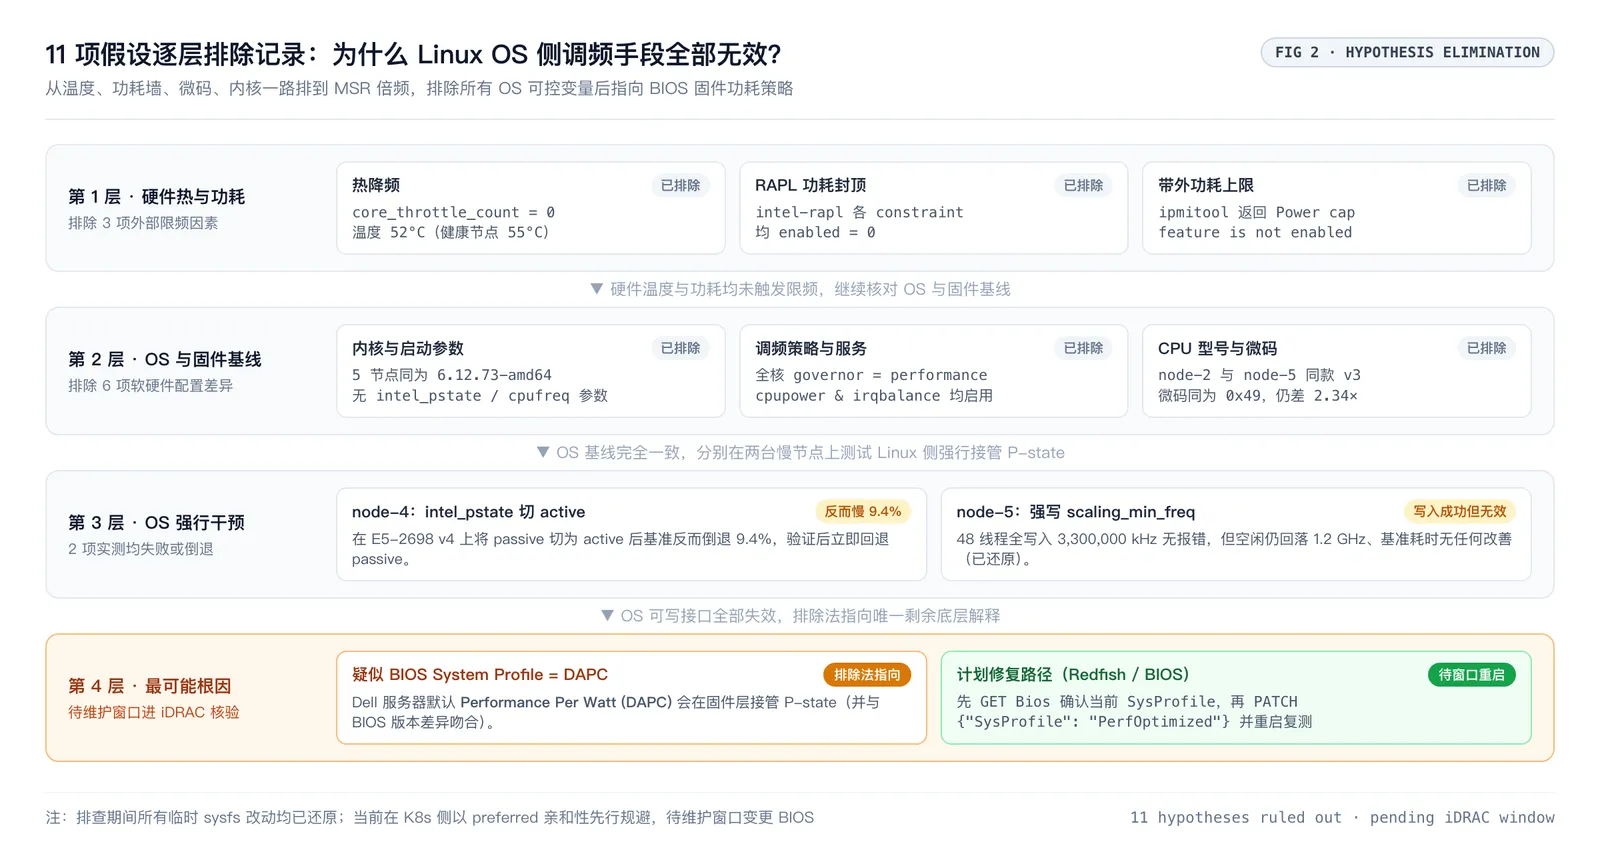
隨後我們按三層排查路徑逐項排除了 11 項假設(3 項硬體熱與功耗 + 6 項 OS 與韌體基線 + 2 項 OS 側強行干預,與下圖一一對應):
cat /sys/devices/system/cpu/cpu0/thermal_throttle/core_throttle_count
grep -H . /sys/class/powercap/intel-rapl:*/constraint_*_enabled
cat /sys/devices/system/cpu/cpu0/cpufreq/scaling_governor
ipmitool dcmi power reading- 第 1 層 · 硬體熱與功耗(排除 3 項):
- 熱降頻:
core_throttle_count = 0,慢節點溫度52°C,比健康節點的55°C還低; - RAPL 功耗封頂:
intel-rapl各 constraint 全部為enabled = 0; - 帶外功耗上限:
ipmitool返回Power cap set feature is not enabled。
- 熱降頻:
- 第 2 層 · OS 與韌體基線(排除 6 項):
- 5 臺節點的核心版本(
6.12.73-amd64)、核心啟動引數(無intel_pstate=/cpufreq=)、全核governor = performance、cpupower-performance.service與irqbalance服務狀態,以及node-2/node-5之間的 CPU 型號與微碼全部一致。
- 5 臺節點的核心版本(
- 第 3 層 · OS 側強行干預(排除 2 項):
- 在
node-4(E5-2698 v4)將intel_pstate從passive切到active,基準耗時反而慢了 9.4%(驗證後立即還原); - 在
node-5(48 執行緒)將全部邏輯核的scaling_min_freq寫成3,300,000,寫入成功無報錯,但空閒頻率仍跌回1.2 GHz,耗時無改善(同樣已還原)。
- 在
最後用 taskset -c 2 將單執行緒死迴圈繫結到 2 號核,配合 scaling_cur_freq 與 rdmsr(0x199 IA32_PERF_CTL 讀請求倍頻、0x198 IA32_PERF_STATUS 讀硬體實際倍頻)連續取樣,看到了關鍵異常:
taskset -c 2 yes > /dev/null &
for i in 1 2 3 4 5; do
  freq=$(cat /sys/devices/system/cpu/cpu2/cpufreq/scaling_cur_freq)
  req=$(( (0x$(rdmsr -p 2 0x199) >> 8) & 0xff ))
  act=$(( (0x$(rdmsr -p 2 0x198) >> 8) & 0xff ))
  echo "sample $i: ${freq} kHz | req=${req} | act=${act}"
  sleep 1
done
取樣結果如下:
# node-5(慢节点)
空闲 cpu2 = 1,200,062 kHz
采样 1: 2,499,976 kHz | req=28 | act=25
采样 2: 3,113,208 kHz | req=33 | act=29   ← 硬件可瞬时冲到 3.11 GHz(非原子采样略有错峰)
采样 5: 1,199,946 kHz | req=12 | act=12   ← 满载中又掉回最低档

# node-2(健康节点)
空闲 cpu2 = 2,900,021 kHz                 ← 空闲也稳定在高频
采样 1~5: 2,883,520 ~ 2,899,999 kHz | req=33 | act=29
這組取樣反映出兩個物理細節:
- 健康節點
node-2請求倍頻恆定33(3.3 GHz),實際穩定在29(2.9 GHz),這是 E5-2680 v3 關閉深 C-States 後的全核睿頻檔位;而node-5開啟了深 C-States,單核滿載時偶爾能衝到3.11 GHz,但絕大多數時間像運行於powersave模式下一樣在1.2 GHz徘徊; performancegovernor 下的第 5 次取樣竟然出現req=12,說明連 OS 側發出的請求倍頻本身都被壓低了(通常源於韌體透過 ACPI_PPC動態收緊bios_limit;本次排查遺漏了檢視/sys/devices/system/cpu/cpu2/cpufreq/bios_limit,下次維護視窗進機房時會一併核對)。
排空所有 OS 層可寫介面後,最可能的根因指向 Dell 伺服器 BIOS 的 System Profile 停留在預設的 Performance Per Watt (DAPC)(與兩臺機器的 BIOS 版本差異也吻合)。ipmitool 無法修改該項,受限於生產維護視窗我們尚未透過 iDRAC 完成改配與重啟,先按 Dell Redfish 文件記下核驗與變更路徑(Dell 13G 上選擇 PerfOptimized 預設會自動託管子項;若要單獨覆寫 ProcCStates 等子屬性,SysProfile 須設為 Custom):
# 1. 先查当前 BIOS 实际配置,确认 SysProfile 是否为 DAPC
curl -sk -u <user>:<pass> \
  https://<idrac-host>/redfish/v1/Systems/System.Embedded.1/Bios | jq '.Attributes | {SysProfile, ProcPwrPerf, ProcCStates}'

# 2. 切为 PerfOptimized 并创建重启生效任务(待维护窗口执行验证)
curl -sk -u <user>:<pass> -X PATCH \
  https://<idrac-host>/redfish/v1/Systems/System.Embedded.1/Bios/Settings \
  -H 'Content-Type: application/json' \
  -d '{"Attributes":{"SysProfile":"PerfOptimized"}}'

curl -sk -u <user>:<pass> -X POST \
  https://<idrac-host>/redfish/v1/Managers/iDRAC.Embedded.1/Jobs \
  -H 'Content-Type: application/json' \
  -d '{"TargetSettingsURI":"/redfish/v1/Systems/System.Embedded.1/Bios/Settings"}'
當叢集同時承載分散式塊儲存時,節點降頻的影響不只停留在資料庫 Pod——儲存守護程序的校驗和與編碼路徑同樣依賴單核主頻,也會拉高整池的儲存寫延遲。
8 輪壓測全記錄(E3 作廢,7 輪有效):翻車與驗證
以下是 8 輪 pgbench 全量資料(表頭中的 c=32、c=64 為客戶端併發連線數)。前 3 輪 R1–R3 是固定資料集前的早期探索輪次(高噪聲),E1–E5 才是嚴格對照資料:
| 輪次 | 階段 | 關鍵變更 | 寫 c=32 | 寫 c=64 | 讀主庫 c=32 | 讀主庫 c=64 | 讀副本 c=64 | 備註 |
|---|---|---|---|---|---|---|---|---|
R1 | 舊方法 | 初始基線(max_wal_size=8GB) | 4,318 | 6,219 | 58,429 | 55,915 | 75,619 | 高噪聲基線 |
R2 | 舊方法 | max_wal_size=24GB + zstd + 激進 bgwriter | 4,113 | 6,022 | 55,652 | 55,522 | 74,602 | WAL I/O 顯著改善,低併發只讀掉速 |
R3 | 舊方法 | bgwriter 回退預設 | 3,912 | 5,819 | 52,249 | 54,788 | 66,557 | 高噪聲階段,保守回退預設 |
E1 | 固化 | 新方法論基線(8 vCPU) | 3,878 | 6,160 | 57,204 | 55,022 | 73,155 | 離散度收斂至 1%–3% |
E2 | 固化 | 開啟 commit_delay=1700µs | 3,064 | 5,688 | 57,550 | 54,528 | 70,014 | 寫 c=32 暴跌 -21%,立即回退 |
E3 | 固化 | CPU 8 核 → 16 核 | — | — | — | — | — | 觸發重排程,主庫落慢節點、副本離慢節點,本輪作廢 |
E4 | 固化 | 親和性排除慢節點 + 16 vCPU | 3,585 | 5,615 | 52,644 | 55,951 | 98,859 | 副本 +35%(來自逃離慢節點) |
E5 | 固化 | CPU 從 16 核降回 12 核 | 3,794 | 5,665 | 51,641 | 52,838 | 95,686 | 與 16 核基本持平,確認 CPU 非瓶頸 |
E4/E5的寫吞吐及主庫只讀相比E1低了約7%–10%(例如E5讀主庫c=32為51,641vsE1的57,204):核對落點,E4/E5主庫落在了無睿頻的node-3(2,500 MHz),而E1在node-1(該次壓測實測2,889 MHz,健康節點間約13%主頻差)。
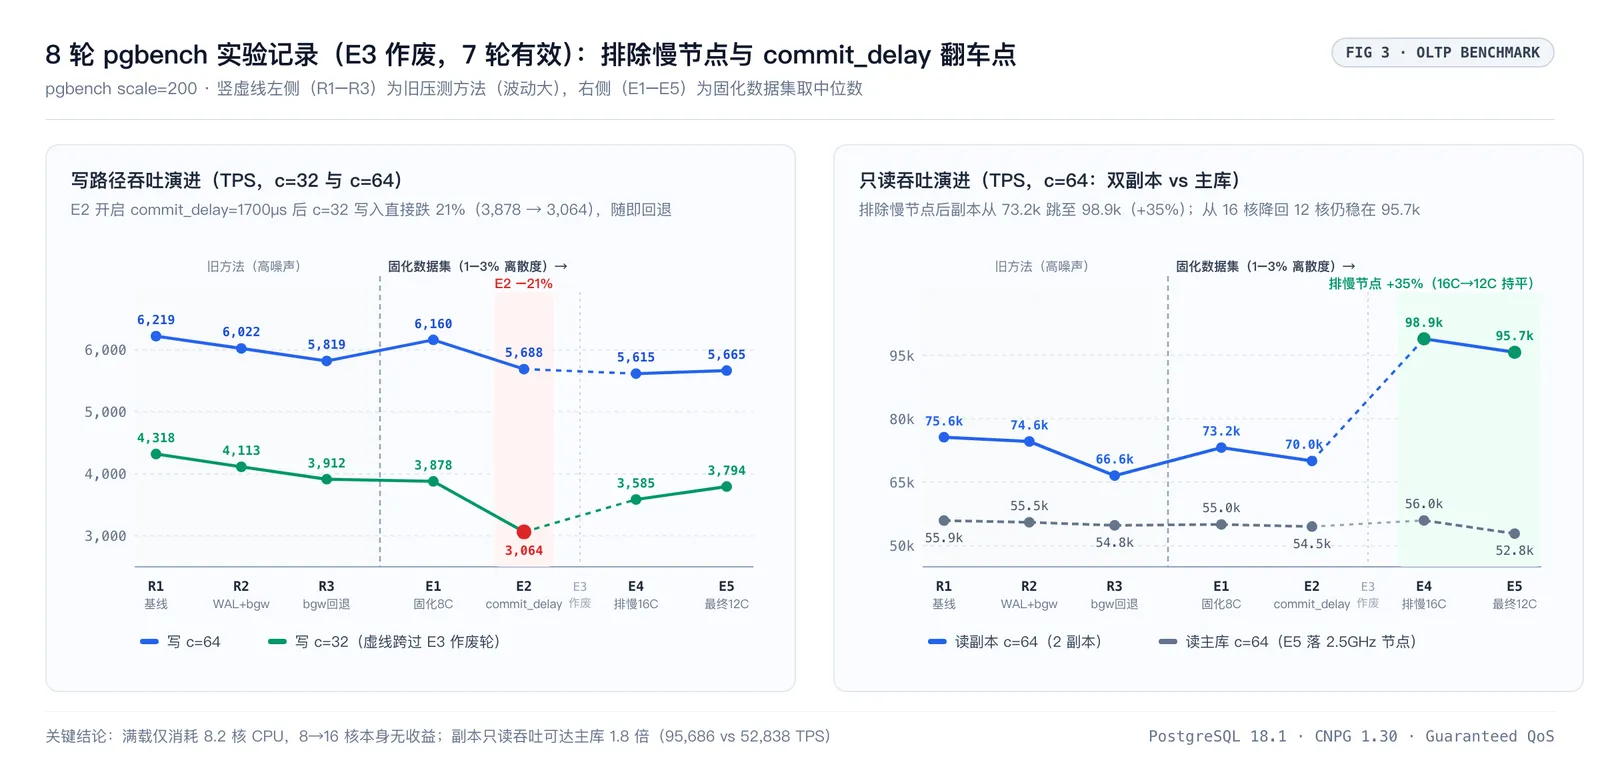
這 8 輪實驗用實測證偽了一項常見調優(commit_delay),主動放棄了兩項不適配當前負載的新特性(PostgreSQL 18 AIO 與 HugePages),並將早期高噪聲階段嘗試的激進 bgwriter 引數保守回退回了預設值。
實測回退:開啟 commit_delay 讓寫入跌掉 21%
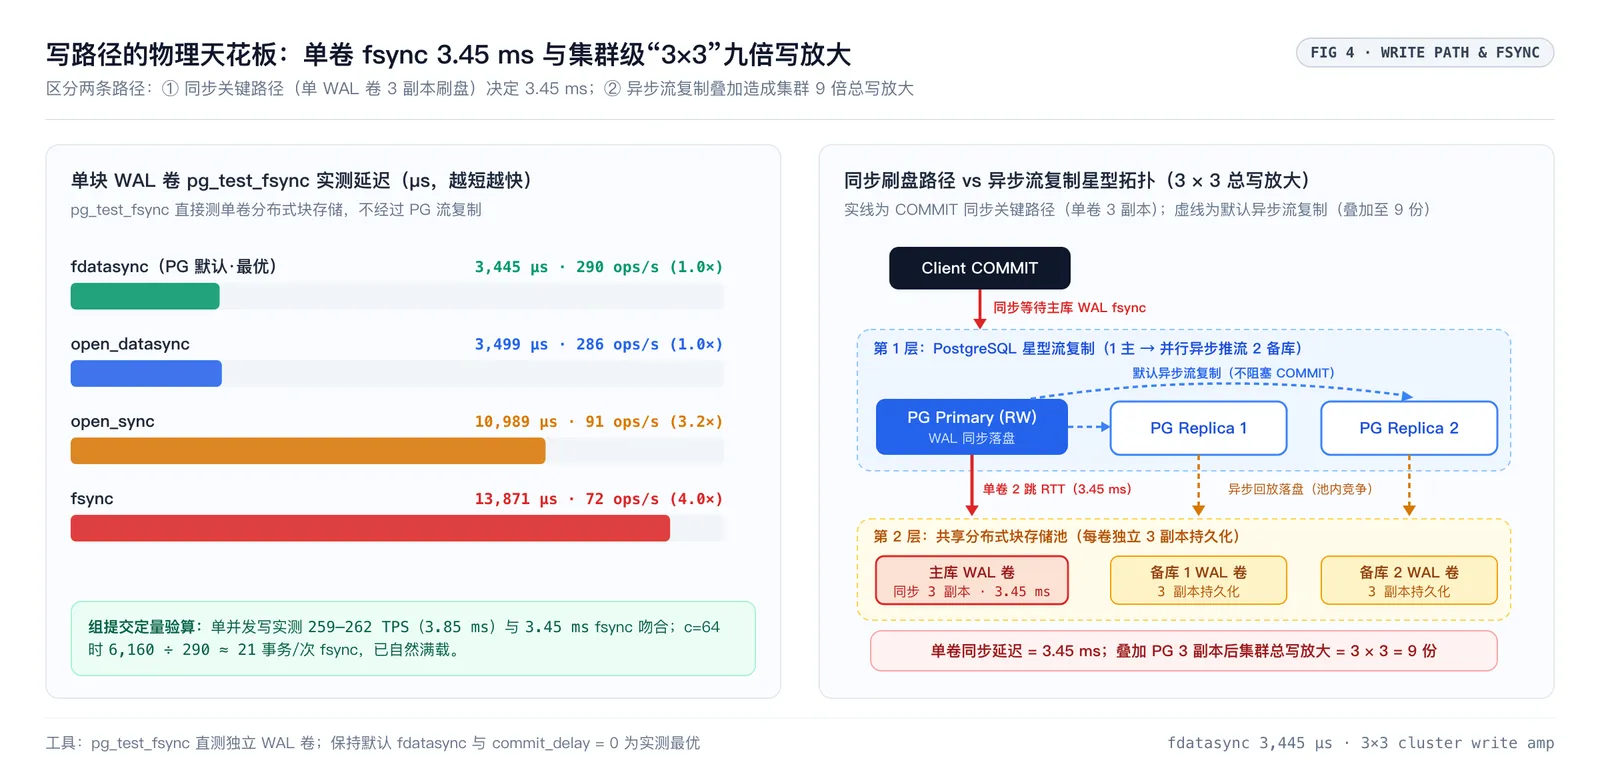
使用 PostgreSQL 自帶的 pg_test_fsync 直接測試單獨掛載的 WAL 卷(底層為三副本分散式塊儲存):
pg_test_fsync -f /var/lib/postgresql/wal/test_fsync.out| sync 方法 | 平均延遲 | ops/sec | 對比預設 |
|---|---|---|---|
fdatasync(PG 預設) | 3,445 µs | 290 | 最優 |
open_datasync | 3,499 µs | 286 | 持平 |
open_sync | 10,989 µs | 91 | 慢 3.2 倍 |
fsync | 13,871 µs | 72 | 慢 4.0 倍 |
將這兩組實測值對比即可定位寫路徑瓶頸:
- 單併發寫入實測
259–262 TPS(每事務3.85 ms),與3.45 ms的fdatasync基本重合——單併發寫完全受限於單卷fsync; c=64時寫入為6,160 TPS,6,160 ÷ 290 fsync/s ≈ 21,說明在3.45 ms的自然刷盤視窗內,每次fdatasync已經自然積攢了約 21 個事務做組提交。
此時再疊加 1,700 µs 的 commit_delay,等於白白多等 1.7 ms,導致 c=32 寫入吞吐直接回落 21%。
從儲存鏈路看,單次 pg_test_fsync = 3.45 ms 測的是單塊 WAL 卷經過分散式塊儲存 3 副本同步寫 + 2 跳儲存網路 RTT 的延遲(不經過 PG 流複製);而在整個 1 主 2 備的非同步流複製集群裡,每次事務最終會落成 PG 3 實例 × 塊儲存 3 副本 = 9 份持久化。這雖然不阻塞主庫非同步 COMMIT,卻會在共享儲存池中放大 3 倍 IOPS 爭用,間接推高儲存延遲。
主動放棄:PostgreSQL 18 AIO(io_uring)與 HugePages
容器映像已連結 liburing,io_method=io_uring 可以直接開啟,但實測後我們放棄了調整 io_method、io_workers 與 io_combine_limit:
- PostgreSQL 18 的非同步 I/O 目前僅覆蓋順序掃描、點陣圖堆掃描和
VACUUM,不覆蓋索引點查;pgbench全走索引,AIO 不會生效; - 這套叢集的核心熱工作集遠小於
4 GB的shared_buffers,常駐記憶體。即便專門構造11 GB順序掃描資料集壓測儲存讀,第 2、3 次掃描也會被容器的 Linux Page Cache 完整命中(全程1.8 s,實際讀 I/O 僅154 ms,測出的是6 GB/s記憶體頻寬)。
HugePages 同樣放棄:宿主機每節點只預留了 2 GiB,裝不下 4 GB 的 shared_buffers。
至於早期探索輪 R2 嘗試的激進 bgwriter 引數,因為當時處於高噪聲階段(且上表裡回退後的 R3 受噪聲影響波動很大,不足以作為嚴格證偽),但低併發只讀確實觀測到了 13%–19% 回退且對寫吞吐無益,最終保守回退為預設值(bgwriter_delay=200ms、lru_maxpages=100、lru_multiplier=2.0)。
產出確定性收益的三處改動
max_wal_size(8 GB → 24 GB)與 wal_compression=zstd
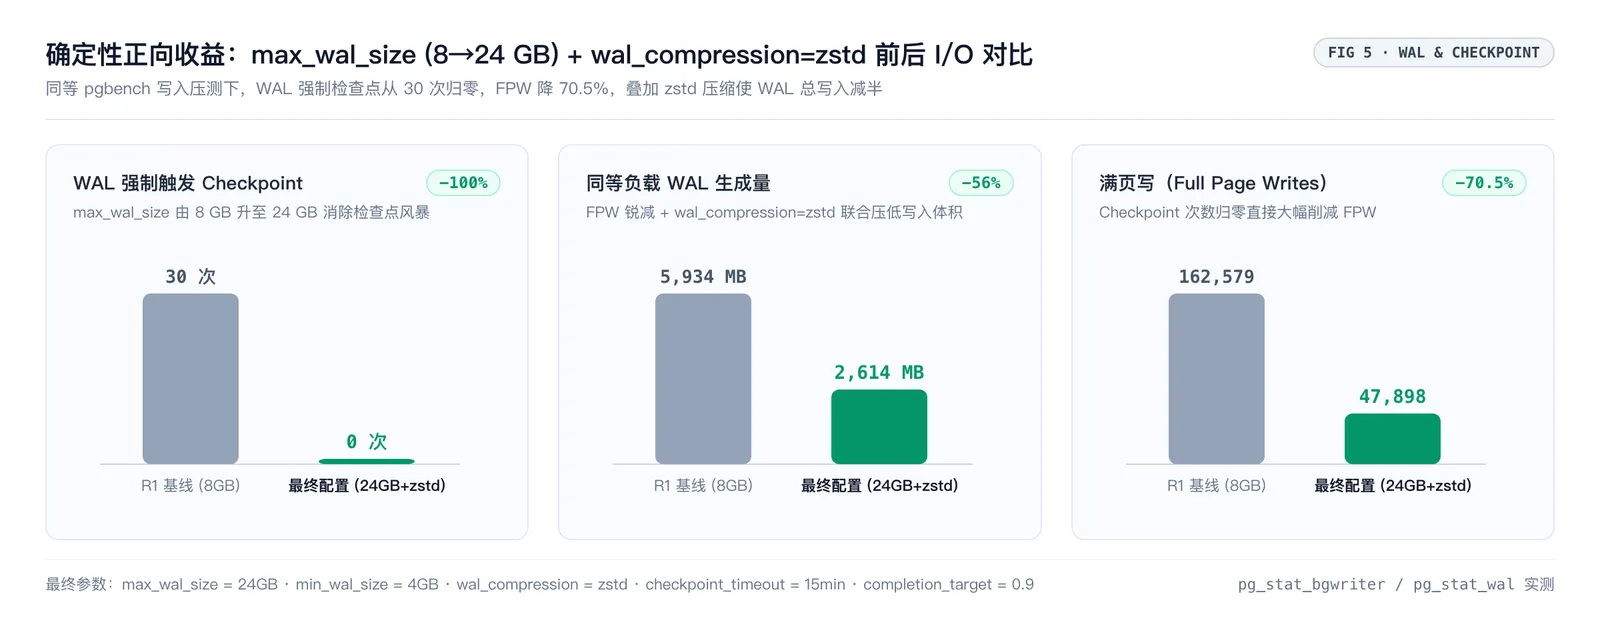
初始基線(R1)配置的 max_wal_size 為 8 GB,壓測期間被 WAL 頻繁填滿,連續觸發了 30 次強制 Checkpoint,並伴生大量 Full Page Writes(FPW,滿頁寫)。調至 24 GB 並開啟 zstd 壓縮後,同等寫入負載下的 I/O 指標大幅下降:
- WAL 強制觸發 Checkpoint:
30 次 → 0 次; - 滿頁寫(FPW)次數:
162,579 → 47,898(-70.5%); - 同負載 WAL 總生成量:
5,934 MB → 2,614 MB(-56%)(Checkpoint 歸零削減 FPW 與zstd壓縮共同作用)。
單實例 66k TPS 讀平台定位:切 prepared 語句提升 21%
滿載只讀時容器 CPU 只用了 8.2 / 16 核,單實例卻停在 5–6 萬 TPS 上不去。我們從四個維度逐一排查:
- CFS CPU 節流:
7,059個週期僅發生10次節流(0.14%); - 跨節點網路:同節點直連
62,376vs 跨節點56,463 TPS,跨節點網路開銷約佔10%; - PG 內部鎖爭用:壓測期間多次抓取活躍會話等待事件,累計
130 / 130全部是Client/ClientRead,服務端沒有內部鎖排隊;
SELECT wait_event_type, wait_event, count(*)
FROM pg_stat_activity
WHERE state = 'active' AND pid <> pg_backend_pid()
GROUP BY 1, 2
ORDER BY 3 DESC;- 客戶端發壓能力:同一臺壓測端同時打兩個只讀副本跑到了
98,859 TPS,客戶端未到上限。
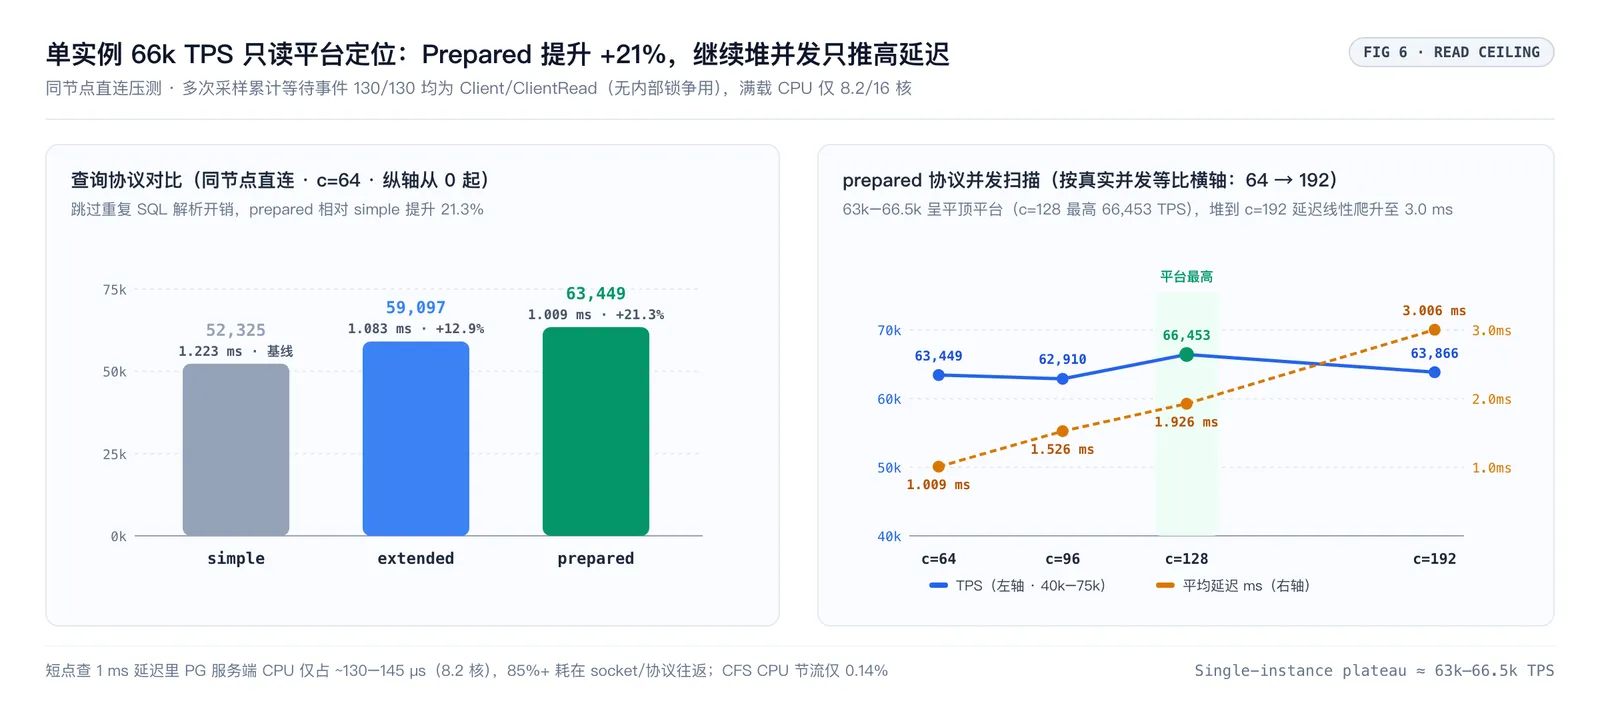
接著在同節點直連 c=64 條件下對比 pgbench 三種協議(-M simple、extended、prepared):
pgbench -h <pod-ip> -U postgres -S -c 64 -j 16 -T 60 -M prepared pgbench| 協議模式 | TPS | 平均延遲 | 相對 simple |
|---|---|---|---|
simple | 52,325 | 1.223 ms | 基線 |
extended | 59,097 | 1.083 ms | +12.9% |
prepared | 63,449 | 1.009 ms | +21.3% |
切到 prepared 跳過重複 SQL 解析直接帶來 +21.3% 提升(extended 雖然仍逐次傳送 Parse,但省去了文字轉義與部分協議往返,也快了 12.9%)。繼續在 prepared 模式下掃描併發:
c=64:63,449 TPS(1.009 ms)c=96:62,910 TPS(1.526 ms)c=128:66,453 TPS(1.926 ms)c=192:63,866 TPS(3.006 ms)
吞吐在 63k–66.5k TPS 形成平頂平台,繼續堆併發只會讓延遲線性上漲。按 56k–62k TPS 消耗 8.2 核折算,單次點查在 PostgreSQL 服務端只吃約 130–145 µs CPU,1 ms 平均延遲裡超過 85% 耗在極短查詢的 socket 往返與程序排程上——這正是等待事件全部為 Client/ClientRead 的直接原因。最終我們將單實例 CPU 配額定在 12 核(8.2 核滿載加上系統程序餘量)。
讀寫分離(-rw → -ro)與 K8s 親和性死鎖修正
CloudNativePG 會自動為叢集生成讀寫 Service(<cluster>-rw)和只讀 Service(<cluster>-ro)。兩個只讀副本實測達到 95,686 TPS(主庫的 1.8 倍),而應用此前全部連在 -rw 上,將只讀流量切到 -ro 是最直接的擴容路徑。
排查過程中我們還修復了一處自己差點埋下的高可用隱患:最初在 CloudNativePG 中同時配置了 podAntiAffinity: required(3 個實例必須落在不同節點)和 nodeAffinity: required(只允許排程到 3 臺健康節點)。3 個 Pod 鎖死在 3 臺機器上,意味著只要任意一臺健康節點宕機,重建 Pod 就會一直卡死在 Pending。
發現後我們立即將 nodeAffinity 降級為 preferred(權重 100):
affinity:
    enablePodAntiAffinity: true
    topologyKey: kubernetes.io/hostname
    podAntiAffinityType: required
    nodeAffinity:
        preferredDuringSchedulingIgnoredDuringExecution: # required → preferred,避免故障时一直 Pending
            - weight: 100
              preference:
                  matchExpressions:
                      - key: kubernetes.io/hostname
                        operator: In
                        values: [node-1, node-2, node-3]
日常執行時實例仍優先落在 3 臺高頻節點;真遇單節點故障,可以降級排程到慢節點先保住叢集可用。
當前落地的核心配置與待辦
脫敏後的核心引數(CloudNativePG 1.30 / PostgreSQL 18.1 / Guaranteed QoS):
spec:
    instances: 3
    resources:
        requests: { cpu: '12', memory: 16Gi } # 满载实测 8.2 核,12 核留系统进程余量
        limits: { cpu: '12', memory: 16Gi }
    postgresql:
        parameters:
            max_connections: '500'
            shared_buffers: '4GB'
            effective_cache_size: '12GB'
            work_mem: '16MB'
            maintenance_work_mem: '1GB'
            max_wal_size: '24GB' # 8GB → 24GB,消除 WAL 强制 checkpoint
            min_wal_size: '4GB'
            wal_compression: 'zstd' # 配合 FPW 削减,总 WAL 写入 −56%
            checkpoint_completion_target: '0.9'
            checkpoint_timeout: '15min'
            commit_delay: '0' # 实测开启 −21%,保持关闭
            random_page_cost: '1.1'
            effective_io_concurrency: '200'
            bgwriter_delay: '200ms' # 保持默认
            bgwriter_lru_maxpages: '100'
            bgwriter_lru_multiplier: '2.0'
目前這套叢集先靠 preferred 親和性避開兩臺慢節點。等下次機房維護視窗拿到 iDRAC 憑據後,我們會先核對 bios_limit 與 BIOS SysProfile 現狀,將兩臺機器切到 PerfOptimized 重啟並補測單核頻率與分散式儲存 fsync,屆時整段 nodeAffinity 即可移除。
參考資料
- Tuning AIO in PostgreSQL 18 — Tomas Vondra
- Benchmarking Postgres 17 vs 18 — PlanetScale
- Waiting for Postgres 18: Accelerating Disk Reads with Asynchronous I/O — pganalyze
本文記錄了我們在日常維護公有雲與大模型基礎設施時遇到的真實底層效能問題。如果你正在維護自己的開源專案(尤其是 AI Agent、MCP 或自部署工具),需要按小時計費的雲主機跑演示環境或 DeepSeek 等大模型 API 除錯額度,可以前往 Leaflow 控制台,或在 關於我們 頁面檢視公開合作與聯絡通道。