近期我们在 Kubernetes 上对一套 CloudNativePG(PostgreSQL 18.1,1 主 2 副本)集群做性能摸底。将实例 CPU 配额从 8 核升至 16 核后,滚动重调度带来了一组反直觉的结果:主库性能明显回落,而只读副本吞吐暴涨了 35%。
查看容器监控,满载状态下 PostgreSQL 实际只消耗了 8.2 核。CPU 尚未跑满,从 8 核扩容到 16 核不可能凭空产生 35% 的吞吐增量。对照 Pod 重调度前后的宿主机落点后,原因很快浮出水面:重调度把主库漂移到了一台降频节点上,同时把原本落在慢节点上的只读副本迁移到了健康节点——所谓“加核快 35%”,其实是副本逃离慢节点的假象。我们顺着 cpufreq 一路追到 MSR 倍频寄存器,最终定位出两台空闲跌回 1.2 GHz、满载下仍反复掉档的物理节点。
先校准测量方法:消除早期压测噪声
整次调优一共执行了 8 轮 pgbench 压测,下文表格和图表将其分为两个阶段:前 3 轮探索性测试记作 R1–R3,统一压测口径后的 5 轮正式对照实验记作 E1–E5。
前 3 轮探索测试(R1–R3)存在明显的测试方法缺陷:每次调整参数后都重新执行 pgbench -i 建表,且仅做单次采样。在早期验证稳定性的单并发副本摸底中,同一套配置连跑三轮竟得到 1,577 → 1,676 → 3,531 TPS,波动达到 2.2 倍(该摸底仅用于验证噪声,未计入后文高并发汇总表)。在这种噪声下,任何参数改动都无法得到可靠结论。
从正式对照阶段的首轮(E1)开始,我们固定了三条基准规范:
pgbench scale=200只初始化一次并常驻,所有对比轮次压同一份数据集;- 每次重启实例后先预热一轮,把热页加载进
shared_buffers,每个场景跑 2 次取中位数; pgbench(纯索引点查与更新)只用来观测 CPU、fsync和协议开销;顺序扫描单独测试存储与异步 I/O。
固化口径后,同配置多次采样的离散度收敛至 1%–3%,后续轮次的数据才具备可比性。
同款 CPU 与微码下,单核基准慢 2.34 倍的排查过程
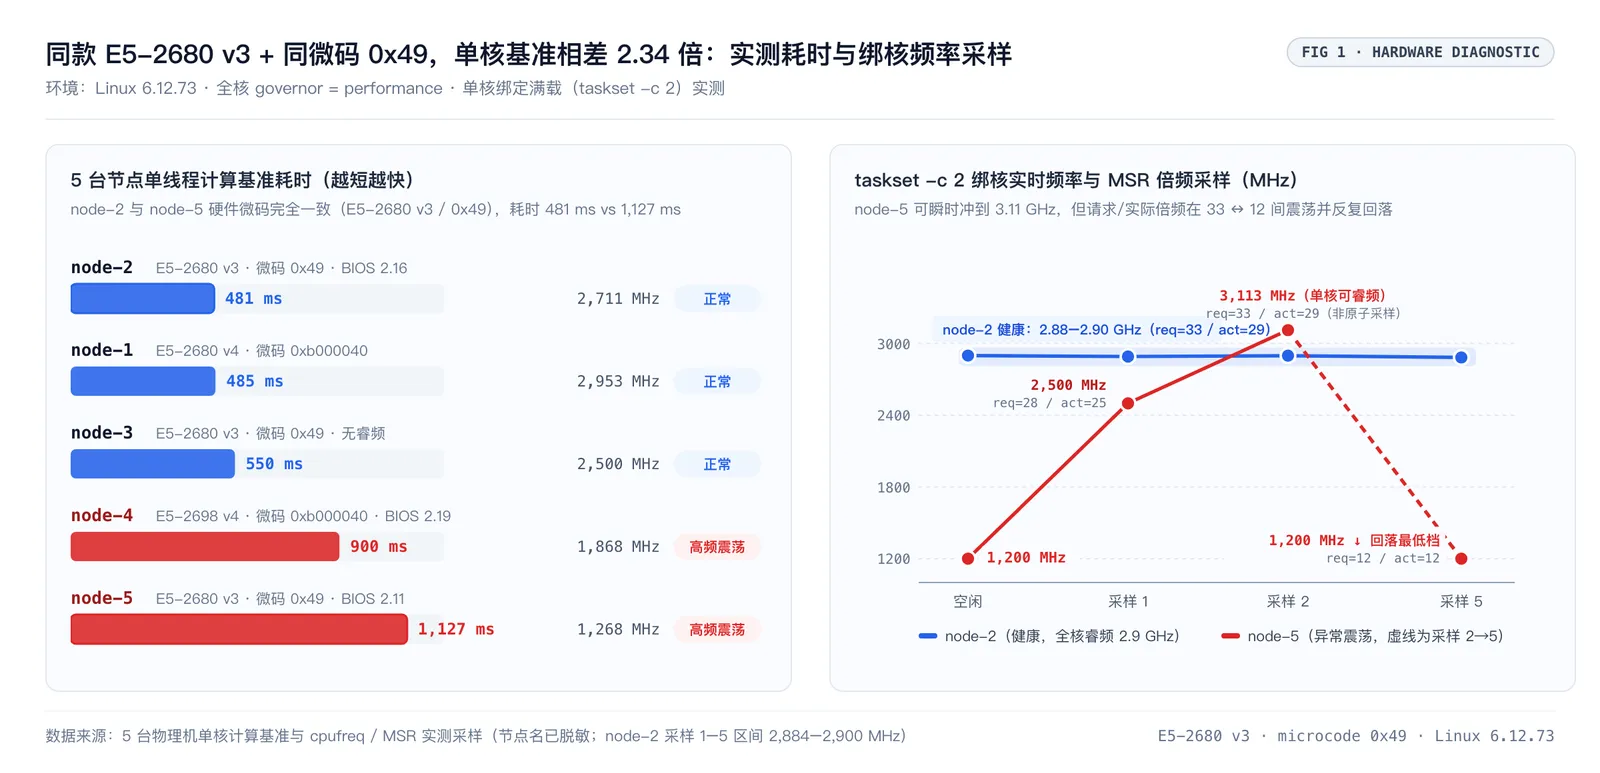
为了排除数据库和 Kubernetes 的干扰,我们对集群里的 5 台物理机直接跑单线程纯 CPU 计算基准,并记录基准运行期间的实际频率(下表按单线程耗时从快到慢排序,表中的“负载后频率”为基准运行时的观测值,与后文 taskset -c 2 绑核每秒抓到的瞬时频率存在少量口径差异):
| 节点(脱敏) | CPU 型号 | 微码 | BIOS 版本 | 单线程计算基准 | 负载后频率 | 状态 |
|---|---|---|---|---|---|---|
node-2 | E5-2680 v3 | 0x49 | 2.16.0 (2022) | 481 ms | 2,711 MHz | 正常 |
node-1 | E5-2680 v4 | 0xb000040 | — | 485 ms | 2,953 MHz | 正常 |
node-3 | E5-2680 v3 | 0x49 | — | 550 ms | 2,500 MHz | 正常(无睿频,跑满基频) |
node-4 | E5-2698 v4 | 0xb000040 | 2.19.0 (2023) | 900 ms | 1,868 MHz | 高频震荡 |
node-5 | E5-2680 v3 | 0x49 | 2.11.0 (2019) | 1,127 ms | 1,268 MHz | 高频震荡 |
node-2 和 node-5 使用同款 E5-2680 v3 处理器、相同微码 0x49、相同 Linux 6.12.73 内核,单核计算耗时分别为 481 ms 和 1,127 ms,相差 2.34 倍。
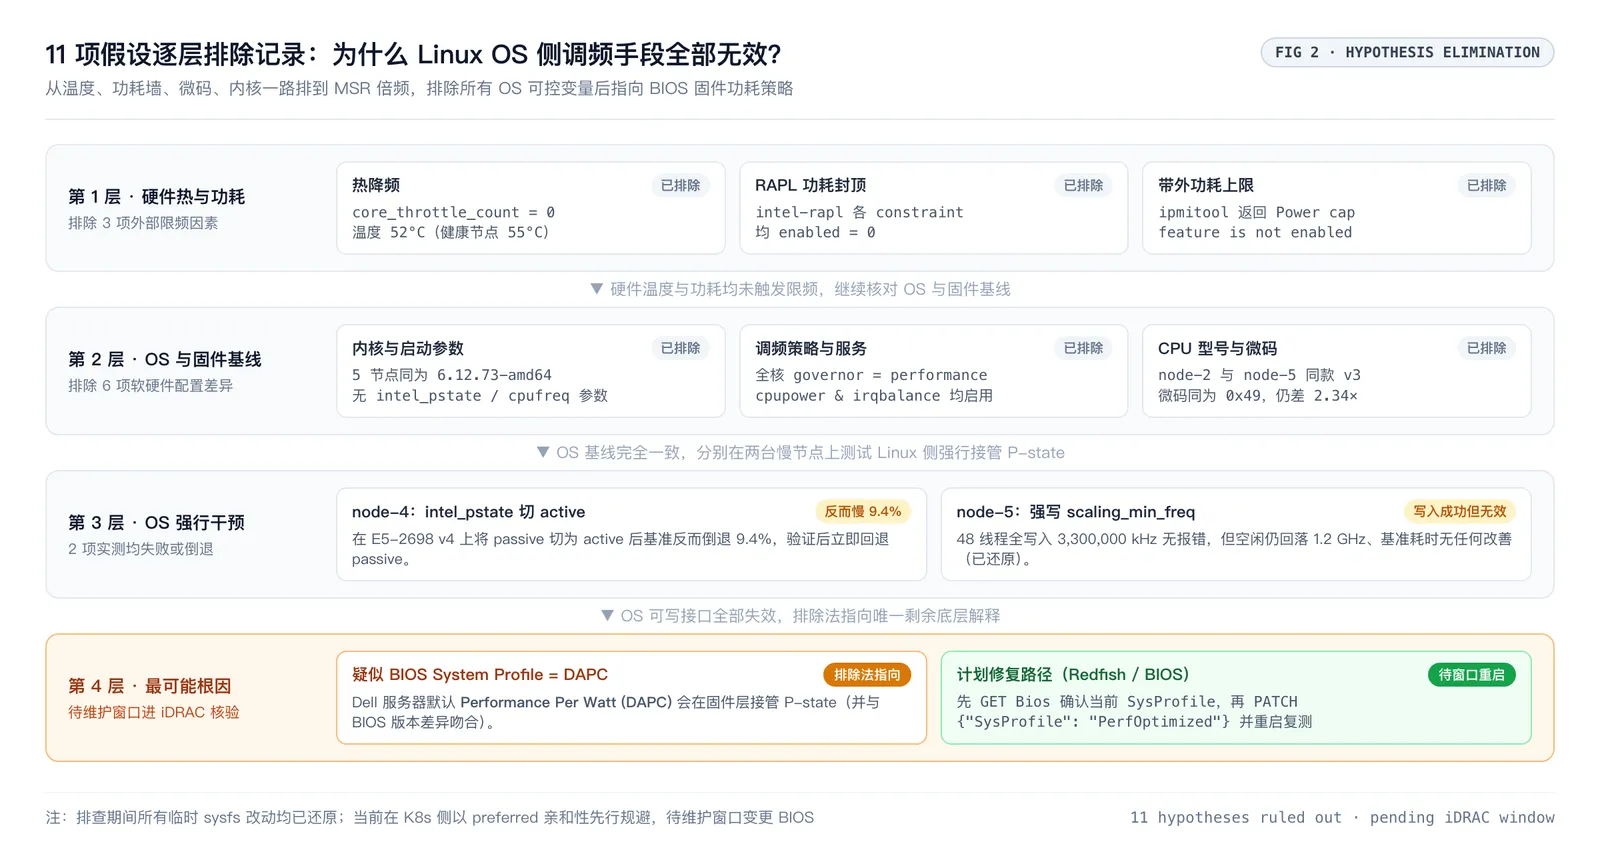
随后我们按三层排查路径逐项排除了 11 项假设(3 项硬件热与功耗 + 6 项 OS 与固件基线 + 2 项 OS 侧强行干预,与下图一一对应):
cat /sys/devices/system/cpu/cpu0/thermal_throttle/core_throttle_count
grep -H . /sys/class/powercap/intel-rapl:*/constraint_*_enabled
cat /sys/devices/system/cpu/cpu0/cpufreq/scaling_governor
ipmitool dcmi power reading- 第 1 层 · 硬件热与功耗(排除 3 项):
- 热降频:
core_throttle_count = 0,慢节点温度52°C,比健康节点的55°C还低; - RAPL 功耗封顶:
intel-rapl各 constraint 全部为enabled = 0; - 带外功耗上限:
ipmitool返回Power cap set feature is not enabled。
- 热降频:
- 第 2 层 · OS 与固件基线(排除 6 项):
- 5 台节点的内核版本(
6.12.73-amd64)、内核启动参数(无intel_pstate=/cpufreq=)、全核governor = performance、cpupower-performance.service与irqbalance服务状态,以及node-2/node-5之间的 CPU 型号与微码全部一致。
- 5 台节点的内核版本(
- 第 3 层 · OS 侧强行干预(排除 2 项):
- 在
node-4(E5-2698 v4)将intel_pstate从passive切到active,基准耗时反而慢了 9.4%(验证后立即还原); - 在
node-5(48 线程)将全部逻辑核的scaling_min_freq写成3,300,000,写入成功无报错,但空闲频率仍跌回1.2 GHz,耗时无改善(同样已还原)。
- 在
最后用 taskset -c 2 将单线程死循环绑定到 2 号核,配合 scaling_cur_freq 与 rdmsr(0x199 IA32_PERF_CTL 读请求倍频、0x198 IA32_PERF_STATUS 读硬件实际倍频)连续采样,看到了关键异常:
taskset -c 2 yes > /dev/null &
for i in 1 2 3 4 5; do
  freq=$(cat /sys/devices/system/cpu/cpu2/cpufreq/scaling_cur_freq)
  req=$(( (0x$(rdmsr -p 2 0x199) >> 8) & 0xff ))
  act=$(( (0x$(rdmsr -p 2 0x198) >> 8) & 0xff ))
  echo "sample $i: ${freq} kHz | req=${req} | act=${act}"
  sleep 1
done
采样结果如下:
# node-5(慢节点)
空闲 cpu2 = 1,200,062 kHz
采样 1: 2,499,976 kHz | req=28 | act=25
采样 2: 3,113,208 kHz | req=33 | act=29   ← 硬件可瞬时冲到 3.11 GHz(非原子采样略有错峰)
采样 5: 1,199,946 kHz | req=12 | act=12   ← 满载中又掉回最低档

# node-2(健康节点)
空闲 cpu2 = 2,900,021 kHz                 ← 空闲也稳定在高频
采样 1~5: 2,883,520 ~ 2,899,999 kHz | req=33 | act=29
这组采样反映出两个物理细节:
- 健康节点
node-2请求倍频恒定33(3.3 GHz),实际稳定在29(2.9 GHz),这是 E5-2680 v3 关闭深 C-States 后的全核睿频档位;而node-5开启了深 C-States,单核满载时偶尔能冲到3.11 GHz,但绝大多数时间像运行在powersave模式下一样在1.2 GHz徘徊; performancegovernor 下的第 5 次采样竟然出现req=12,说明连 OS 侧发出的请求倍频本身都被压低了(通常源于固件通过 ACPI_PPC动态收紧bios_limit;本次排查遗漏了查看/sys/devices/system/cpu/cpu2/cpufreq/bios_limit,下次维护窗口进机房时会一并核对)。
排空所有 OS 层可写接口后,最可能的根因指向 Dell 服务器 BIOS 的 System Profile 停留在默认的 Performance Per Watt (DAPC)(与两台机器的 BIOS 版本差异也吻合)。ipmitool 无法修改该项,受限于生产维护窗口我们尚未通过 iDRAC 完成改配与重启,先按 Dell Redfish 文档记下核验与变更路径(Dell 13G 上选择 PerfOptimized 预设会自动托管子项;若要单独覆写 ProcCStates 等子属性,SysProfile 须设为 Custom):
# 1. 先查当前 BIOS 实际配置,确认 SysProfile 是否为 DAPC
curl -sk -u <user>:<pass> \
  https://<idrac-host>/redfish/v1/Systems/System.Embedded.1/Bios | jq '.Attributes | {SysProfile, ProcPwrPerf, ProcCStates}'

# 2. 切为 PerfOptimized 并创建重启生效任务(待维护窗口执行验证)
curl -sk -u <user>:<pass> -X PATCH \
  https://<idrac-host>/redfish/v1/Systems/System.Embedded.1/Bios/Settings \
  -H 'Content-Type: application/json' \
  -d '{"Attributes":{"SysProfile":"PerfOptimized"}}'

curl -sk -u <user>:<pass> -X POST \
  https://<idrac-host>/redfish/v1/Managers/iDRAC.Embedded.1/Jobs \
  -H 'Content-Type: application/json' \
  -d '{"TargetSettingsURI":"/redfish/v1/Systems/System.Embedded.1/Bios/Settings"}'
当集群同时承载分布式块存储时,节点降频的影响不只停留在数据库 Pod——存储守护进程的校验和与编码路径同样依赖单核主频,也会拉高整池的存储写延迟。
8 轮压测全记录(E3 作废,7 轮有效):翻车与验证
以下是 8 轮 pgbench 全量数据(表头中的 c=32、c=64 为客户端并发连接数)。前 3 轮 R1–R3 是固定数据集前的早期探索轮次(高噪声),E1–E5 才是严格对照数据:
| 轮次 | 阶段 | 关键变更 | 写 c=32 | 写 c=64 | 读主库 c=32 | 读主库 c=64 | 读副本 c=64 | 备注 |
|---|---|---|---|---|---|---|---|---|
R1 | 旧方法 | 初始基线(max_wal_size=8GB) | 4,318 | 6,219 | 58,429 | 55,915 | 75,619 | 高噪声基线 |
R2 | 旧方法 | max_wal_size=24GB + zstd + 激进 bgwriter | 4,113 | 6,022 | 55,652 | 55,522 | 74,602 | WAL I/O 显著改善,低并发只读掉速 |
R3 | 旧方法 | bgwriter 回退默认 | 3,912 | 5,819 | 52,249 | 54,788 | 66,557 | 高噪声阶段,保守回退默认 |
E1 | 固化 | 新方法论基线(8 vCPU) | 3,878 | 6,160 | 57,204 | 55,022 | 73,155 | 离散度收敛至 1%–3% |
E2 | 固化 | 开启 commit_delay=1700µs | 3,064 | 5,688 | 57,550 | 54,528 | 70,014 | 写 c=32 暴跌 -21%,立即回退 |
E3 | 固化 | CPU 8 核 → 16 核 | — | — | — | — | — | 触发重调度,主库落慢节点、副本离慢节点,本轮作废 |
E4 | 固化 | 亲和性排除慢节点 + 16 vCPU | 3,585 | 5,615 | 52,644 | 55,951 | 98,859 | 副本 +35%(来自逃离慢节点) |
E5 | 固化 | CPU 从 16 核降回 12 核 | 3,794 | 5,665 | 51,641 | 52,838 | 95,686 | 与 16 核基本持平,确认 CPU 非瓶颈 |
E4/E5的写吞吐及主库只读相比E1低了约7%–10%(例如E5读主库c=32为51,641vsE1的57,204):核对落点,E4/E5主库落在了无睿频的node-3(2,500 MHz),而E1在node-1(该次压测实测2,889 MHz,健康节点间约13%主频差)。
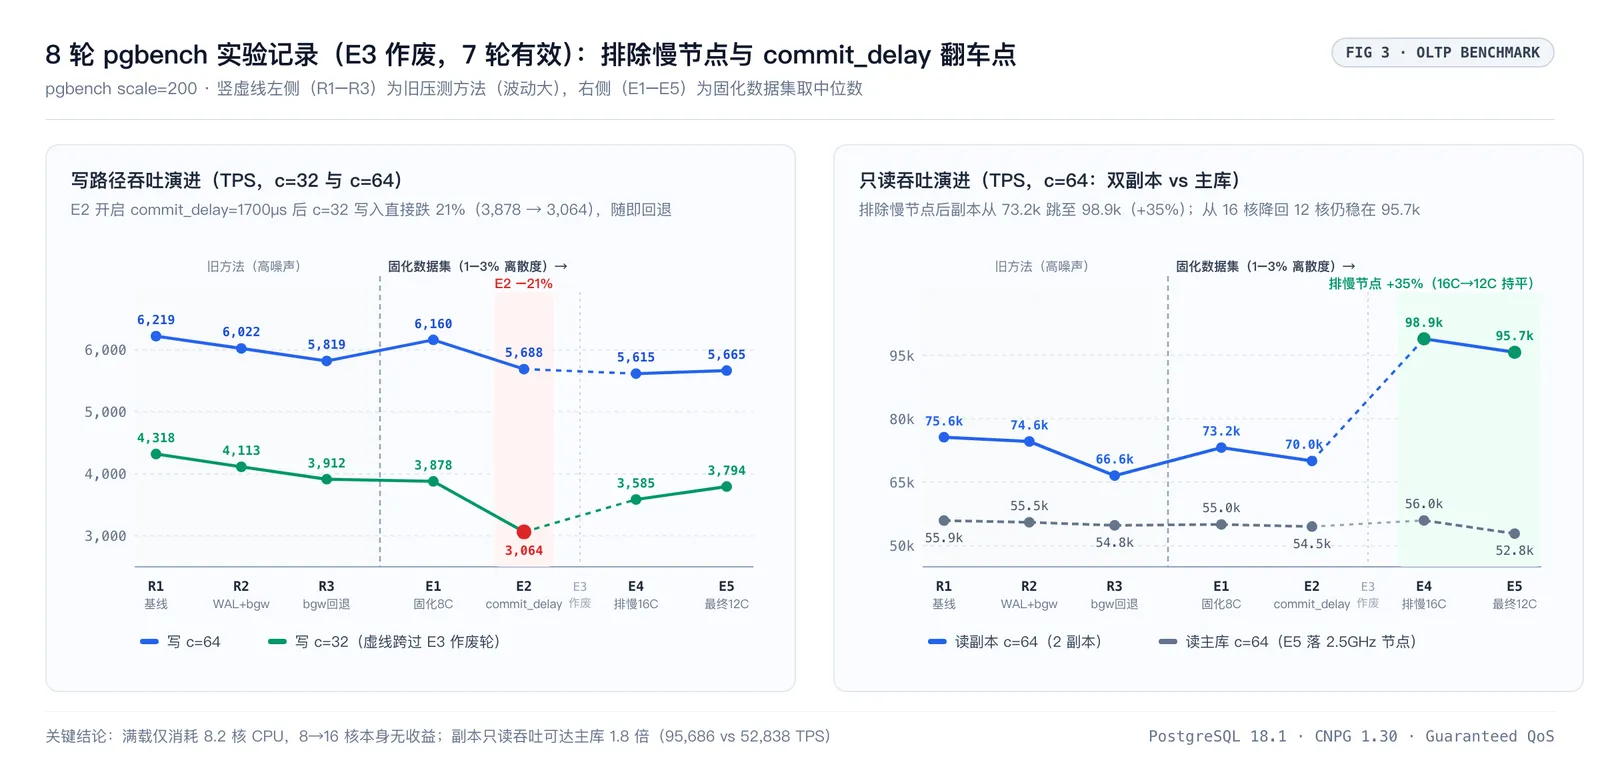
这 8 轮实验用实测证伪了一项常见调优(commit_delay),主动放弃了两项不适配当前负载的新特性(PostgreSQL 18 AIO 与 HugePages),并将早期高噪声阶段尝试的激进 bgwriter 参数保守回退回了默认值。
实测回退:开启 commit_delay 让写入跌掉 21%
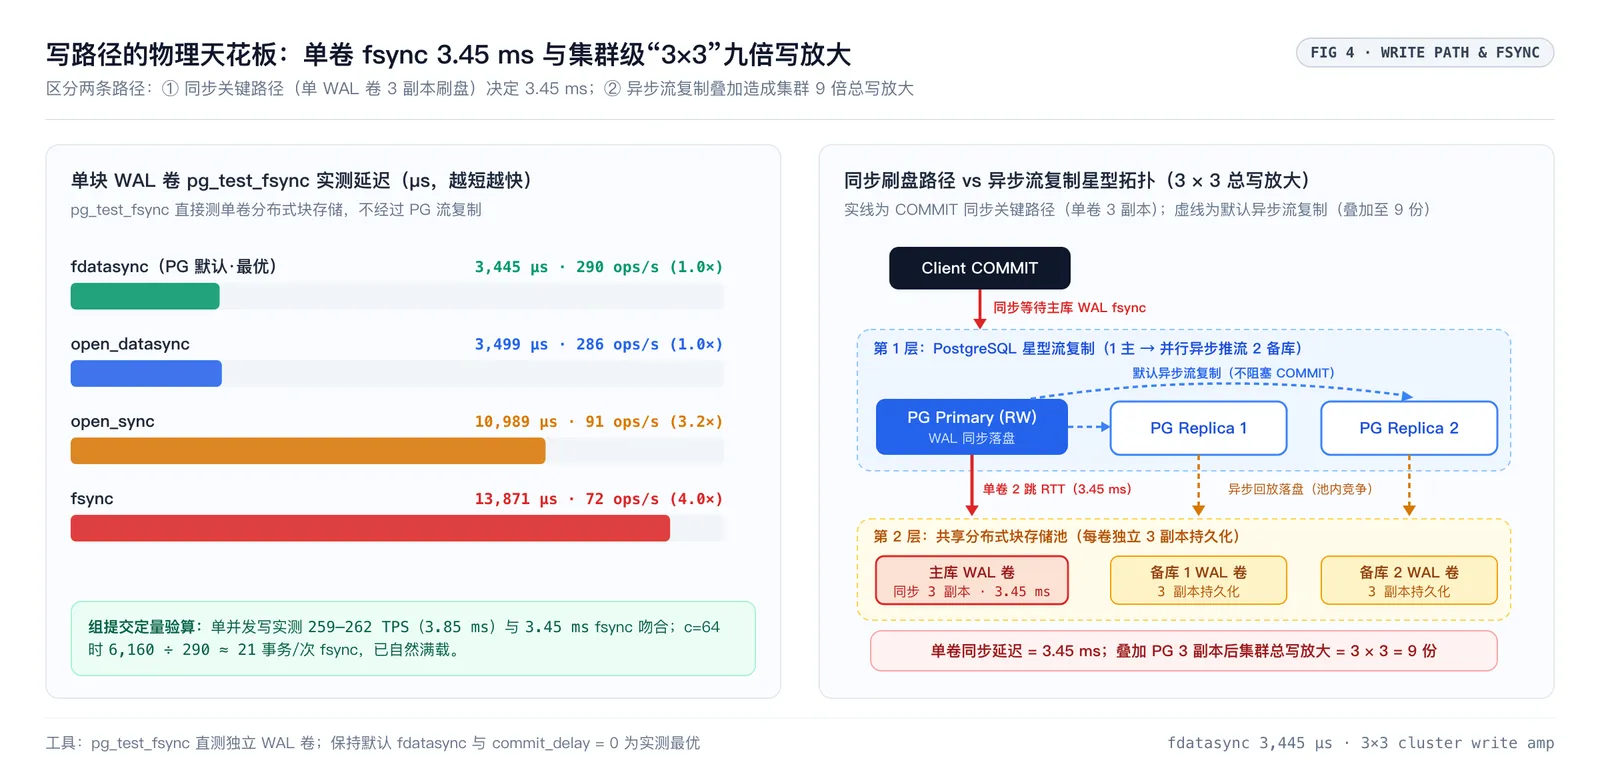
使用 PostgreSQL 自带的 pg_test_fsync 直接测试单独挂载的 WAL 卷(底层为三副本分布式块存储):
pg_test_fsync -f /var/lib/postgresql/wal/test_fsync.out| sync 方法 | 平均延迟 | ops/sec | 对比默认 |
|---|---|---|---|
fdatasync(PG 默认) | 3,445 µs | 290 | 最优 |
open_datasync | 3,499 µs | 286 | 持平 |
open_sync | 10,989 µs | 91 | 慢 3.2 倍 |
fsync | 13,871 µs | 72 | 慢 4.0 倍 |
将这两组实测值对比即可定位写路径瓶颈:
- 单并发写入实测
259–262 TPS(每事务3.85 ms),与3.45 ms的fdatasync基本重合——单并发写完全受限于单卷fsync; c=64时写入为6,160 TPS,6,160 ÷ 290 fsync/s ≈ 21,说明在3.45 ms的自然刷盘窗口内,每次fdatasync已经自然积攒了约 21 个事务做组提交。
此时再叠加 1,700 µs 的 commit_delay,等于白白多等 1.7 ms,导致 c=32 写入吞吐直接回落 21%。
从存储链路看,单次 pg_test_fsync = 3.45 ms 测的是单块 WAL 卷经过分布式块存储 3 副本同步写 + 2 跳存储网络 RTT 的延迟(不经过 PG 流复制);而在整个 1 主 2 备的异步流复制集群里,每次事务最终会落成 PG 3 实例 × 块存储 3 副本 = 9 份持久化。这虽然不阻塞主库异步 COMMIT,却会在共享存储池中放大 3 倍 IOPS 争用,间接推高存储延迟。
主动放弃:PostgreSQL 18 AIO(io_uring)与 HugePages
容器镜像已链接 liburing,io_method=io_uring 可以直接开启,但实测后我们放弃了调整 io_method、io_workers 与 io_combine_limit:
- PostgreSQL 18 的异步 I/O 目前仅覆盖顺序扫描、位图堆扫描和
VACUUM,不覆盖索引点查;pgbench全走索引,AIO 不会生效; - 这套集群的核心热工作集远小于
4 GB的shared_buffers,常驻内存。即便专门构造11 GB顺序扫描数据集压测存储读,第 2、3 次扫描也会被容器的 Linux Page Cache 完整命中(全程1.8 s,实际读 I/O 仅154 ms,测出的是6 GB/s内存带宽)。
HugePages 同样放弃:宿主机每节点只预留了 2 GiB,装不下 4 GB 的 shared_buffers。
至于早期探索轮 R2 尝试的激进 bgwriter 参数,因为当时处于高噪声阶段(且上表里回退后的 R3 受噪声影响波动很大,不足以作为严格证伪),但低并发只读确实观测到了 13%–19% 回退且对写吞吐无益,最终保守回退为默认值(bgwriter_delay=200ms、lru_maxpages=100、lru_multiplier=2.0)。
产出确定性收益的三处改动
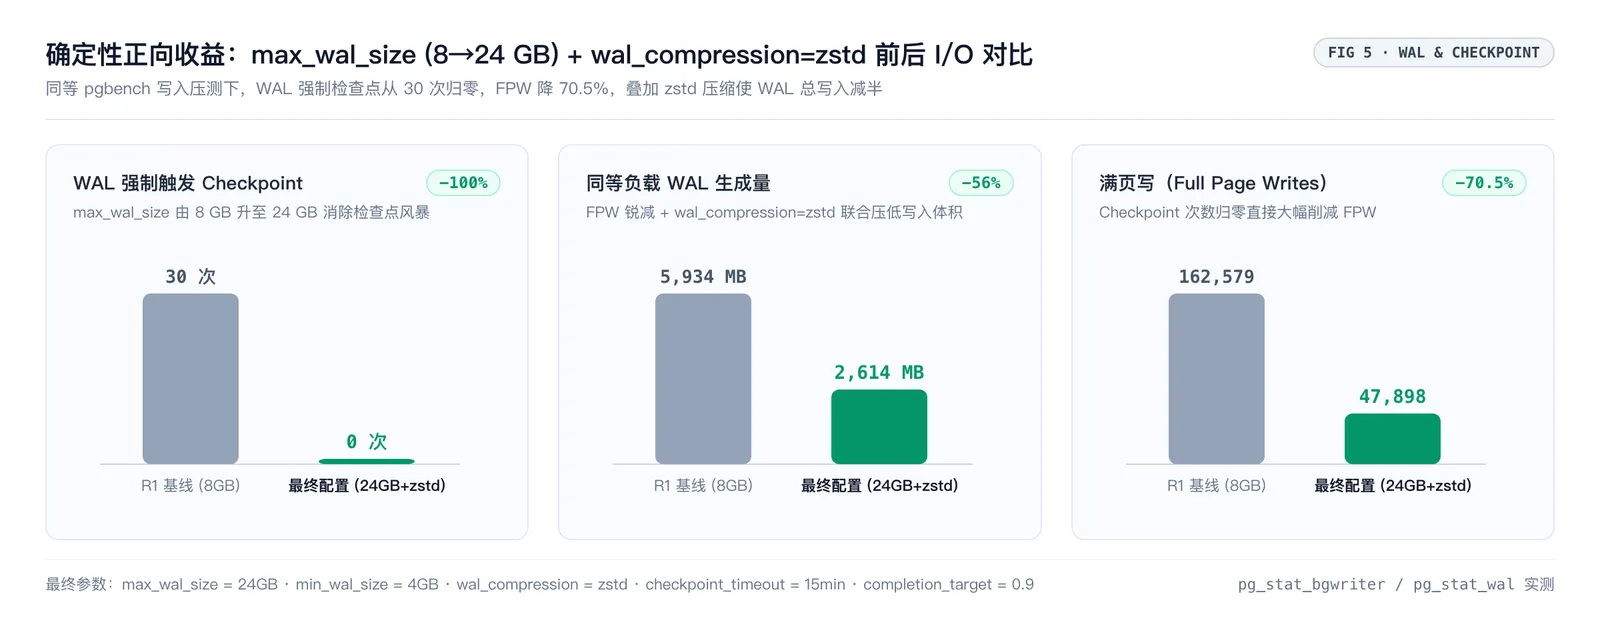
max_wal_size(8 GB → 24 GB)与 wal_compression=zstd
初始基线(R1)配置的 max_wal_size 为 8 GB,压测期间被 WAL 频繁填满,连续触发了 30 次强制 Checkpoint,并伴生大量 Full Page Writes(FPW,满页写)。调至 24 GB 并开启 zstd 压缩后,同等写入负载下的 I/O 指标大幅下降:
- WAL 强制触发 Checkpoint:
30 次 → 0 次; - 满页写(FPW)次数:
162,579 → 47,898(-70.5%); - 同负载 WAL 总生成量:
5,934 MB → 2,614 MB(-56%)(Checkpoint 归零削减 FPW 与zstd压缩共同作用)。
单实例 66k TPS 读平台定位:切 prepared 语句提升 21%
满载只读时容器 CPU 只用了 8.2 / 16 核,单实例却停在 5–6 万 TPS 上不去。我们从四个维度逐一排查:
- CFS CPU 节流:
7,059个周期仅发生10次节流(0.14%); - 跨节点网络:同节点直连
62,376vs 跨节点56,463 TPS,跨节点网络开销约占10%; - PG 内部锁争用:压测期间多次抓取活跃会话等待事件,累计
130 / 130全部是Client/ClientRead,服务端没有内部锁排队;
SELECT wait_event_type, wait_event, count(*)
FROM pg_stat_activity
WHERE state = 'active' AND pid <> pg_backend_pid()
GROUP BY 1, 2
ORDER BY 3 DESC;- 客户端发压能力:同一台压测端同时打两个只读副本跑到了
98,859 TPS,客户端未到上限。
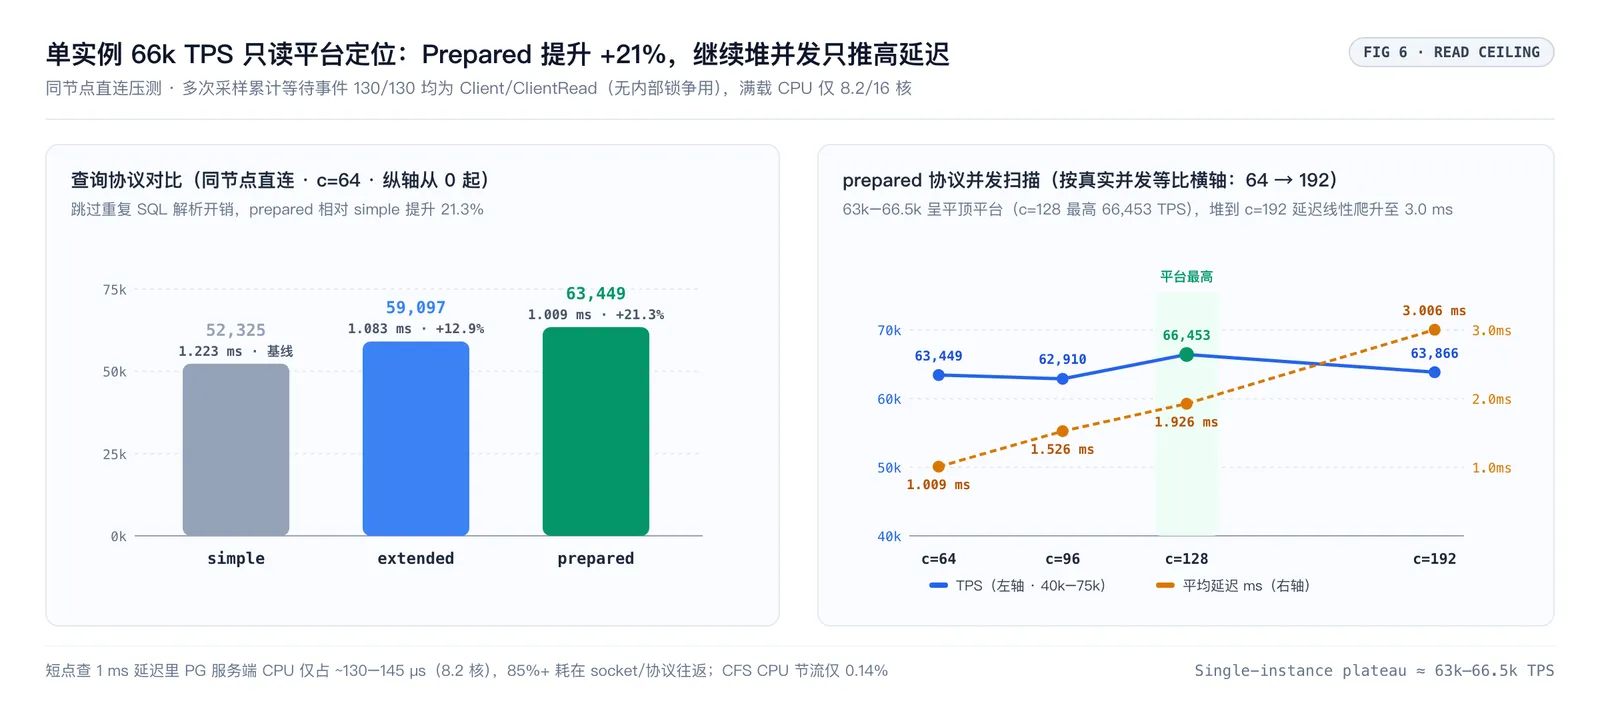
接着在同节点直连 c=64 条件下对比 pgbench 三种协议(-M simple、extended、prepared):
pgbench -h <pod-ip> -U postgres -S -c 64 -j 16 -T 60 -M prepared pgbench| 协议模式 | TPS | 平均延迟 | 相对 simple |
|---|---|---|---|
simple | 52,325 | 1.223 ms | 基线 |
extended | 59,097 | 1.083 ms | +12.9% |
prepared | 63,449 | 1.009 ms | +21.3% |
切到 prepared 跳过重复 SQL 解析直接带来 +21.3% 提升(extended 虽然仍逐次发送 Parse,但省去了文本转义与部分协议往返,也快了 12.9%)。继续在 prepared 模式下扫描并发:
c=64:63,449 TPS(1.009 ms)c=96:62,910 TPS(1.526 ms)c=128:66,453 TPS(1.926 ms)c=192:63,866 TPS(3.006 ms)
吞吐在 63k–66.5k TPS 形成平顶平台,继续堆并发只会让延迟线性上涨。按 56k–62k TPS 消耗 8.2 核折算,单次点查在 PostgreSQL 服务端只吃约 130–145 µs CPU,1 ms 平均延迟里超过 85% 耗在极短查询的 socket 往返与进程调度上——这正是等待事件全部为 Client/ClientRead 的直接原因。最终我们将单实例 CPU 配额定在 12 核(8.2 核满载加上系统进程余量)。
读写分离(-rw → -ro)与 K8s 亲和性死锁修正
CloudNativePG 会自动为集群生成读写 Service(<cluster>-rw)和只读 Service(<cluster>-ro)。两个只读副本实测达到 95,686 TPS(主库的 1.8 倍),而应用此前全部连在 -rw 上,将只读流量切到 -ro 是最直接的扩容路径。
排查过程中我们还修复了一处自己差点埋下的高可用隐患:最初在 CloudNativePG 中同时配置了 podAntiAffinity: required(3 个实例必须落在不同节点)和 nodeAffinity: required(只允许调度到 3 台健康节点)。3 个 Pod 锁死在 3 台机器上,意味着只要任意一台健康节点宕机,重建 Pod 就会一直卡死在 Pending。
发现后我们立即将 nodeAffinity 降级为 preferred(权重 100):
affinity:
    enablePodAntiAffinity: true
    topologyKey: kubernetes.io/hostname
    podAntiAffinityType: required
    nodeAffinity:
        preferredDuringSchedulingIgnoredDuringExecution: # required → preferred,避免故障时一直 Pending
            - weight: 100
              preference:
                  matchExpressions:
                      - key: kubernetes.io/hostname
                        operator: In
                        values: [node-1, node-2, node-3]
日常运行时实例仍优先落在 3 台高频节点;真遇单节点故障,可以降级调度到慢节点先保住集群可用。
当前落地的核心配置与待办
脱敏后的核心参数(CloudNativePG 1.30 / PostgreSQL 18.1 / Guaranteed QoS):
spec:
    instances: 3
    resources:
        requests: { cpu: '12', memory: 16Gi } # 满载实测 8.2 核,12 核留系统进程余量
        limits: { cpu: '12', memory: 16Gi }
    postgresql:
        parameters:
            max_connections: '500'
            shared_buffers: '4GB'
            effective_cache_size: '12GB'
            work_mem: '16MB'
            maintenance_work_mem: '1GB'
            max_wal_size: '24GB' # 8GB → 24GB,消除 WAL 强制 checkpoint
            min_wal_size: '4GB'
            wal_compression: 'zstd' # 配合 FPW 削减,总 WAL 写入 −56%
            checkpoint_completion_target: '0.9'
            checkpoint_timeout: '15min'
            commit_delay: '0' # 实测开启 −21%,保持关闭
            random_page_cost: '1.1'
            effective_io_concurrency: '200'
            bgwriter_delay: '200ms' # 保持默认
            bgwriter_lru_maxpages: '100'
            bgwriter_lru_multiplier: '2.0'
目前这套集群先靠 preferred 亲和性避开两台慢节点。等下次机房维护窗口拿到 iDRAC 凭据后,我们会先核对 bios_limit 与 BIOS SysProfile 现状,将两台机器切到 PerfOptimized 重启并补测单核频率与分布式存储 fsync,届时整段 nodeAffinity 即可移除。
参考资料
- Tuning AIO in PostgreSQL 18 — Tomas Vondra
- Benchmarking Postgres 17 vs 18 — PlanetScale
- Waiting for Postgres 18: Accelerating Disk Reads with Asynchronous I/O — pganalyze
本文记录了我们在日常维护公有云与大模型基础设施时遇到的真实底层性能问题。如果你正在维护自己的开源项目(尤其是 AI Agent、MCP 或自部署工具),需要按小时计费的云主机跑演示环境或 DeepSeek 等大模型 API 调试额度,可以前往 Leaflow 控制台,或在 关于我们 页面查看公开合作与联系通道。